 Panelize
 › 国产 AI 怎么选
DeepSeek、Kimi、豆包、通义千问、元宝怎么选?
各家模型更新太快,网上的排行榜和测评很快就过时,也很少测到你真正要做的事。最靠谱的办法:用同一个问题同时问它们,把答案并排看。
为什么没有「最好的 AI」
- 更新频繁:每家一年都会发好几次新模型,上个季度的排名现在可能已经不对了。
- 看任务:有的擅长写作,有的擅长长文档,有的推理更稳,换个任务结论就变了。
- 看模式:同一个产品的深度思考、联网搜索等模式开不开,结果差别很大。
公平测试的五个步骤
- 同一个问题,一字不差。措辞的小变化对结果的影响,可能比模型本身还大。
- 都开新对话。之前的聊天记录和记忆会影响回答。
- 模式对齐。要么都开深度思考,要么都不开;联网搜索也一样。记下每家用的是什么模式。
- 每题跑两三次。同一个模型每次回答都会不一样,对一次错两次就不算靠谱。
- 按清单打分(见下文),别只看谁回答得最自信。
按场景准备测试题
最好用你自己的真实任务。下面几题可以先拿来试:
写作
把下面这段话改写成发给领导的工作汇报:不超过 150 字,保留所有数字,最后提出一个明确的请求。[粘贴原文]
长文档
用 5 条要点总结这份文档,给没读过的人看;然后列出总结里漏掉的重要信息。[粘贴文档]
编程
这是一段代码和它的报错。用两句话说明根本原因,再给出改动最小的修复。[粘贴代码和报错]
推理
笔只按盒卖,3 支一盒 2 元;笔记本 1.75 元一本。我有 20 元,至少要买 4 本笔记本,最多能买多少支笔?写出计算过程。
查资料
关于 [话题],支持和反对的主要观点分别是什么?不确定的说法请标出来,并说明用什么来源可以核实。
打分清单
| 项目 | 看什么 |
|---|---|
| 准确 | 事实、数字、代码对不对,看不出来的一定要自己核实。 |
| 听话 | 有没有遵守你给的字数、格式和限制条件。 |
| 具体 | 给的是具体做法,还是泛泛而谈。 |
| 不瞎编 | 不确定时会说明,而不是编造出处或数据。 |
| 能直接用 | 拿来用之前还要改多少。 |
几家答案一致的地方更可信;有分歧的地方,就是最该自己核实的地方。
用 Panelize 一次测完
手动测试要把同一个问题复制到五个标签页、来回切换。Panelize 是免费开源的 Chrome 扩展,把 DeepSeek、Kimi、豆包、通义千问、腾讯元宝的官网放在同一个窗口,一次输入同时发送。还可以把 ChatGPT、Claude、Gemini 也加进来一起比。
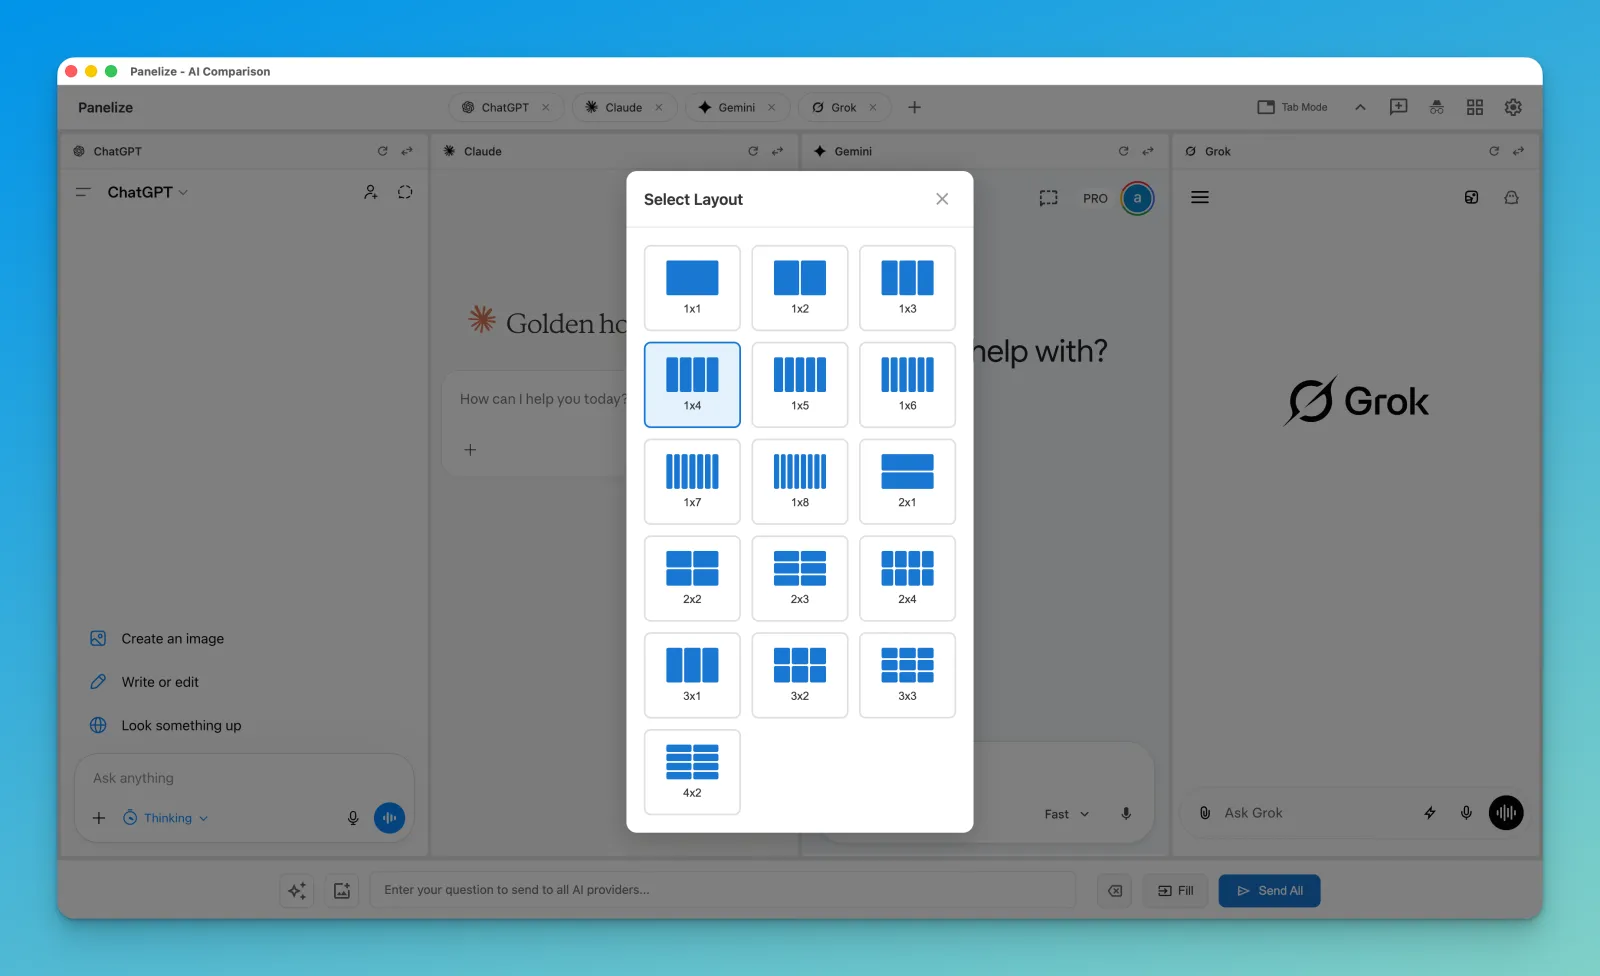
- 按 Cmd/Ctrl + Shift + E 打开 Panelize,选一个 5 格以上的布局,比如 1×5 或 2×3。
- 面板选 DeepSeek、Kimi、豆包、通义千问、元宝。
- 点 New Chat for All(全部新对话),保证每个面板都是干净的新对话。
- 粘贴问题,先点 Fill(填入),在每个面板里把模式对齐,再点 Send All(全部发送)。
- 把测试题存进「提示词库」,可以用
{话题}这样的变量。下次有新模型发布,直接再跑一遍。
Panelize 用的是你已登录的账号,不需要 API Key,也不收集任何数据。
免费、开源、无需 API Key。
免费添加到 Chrome